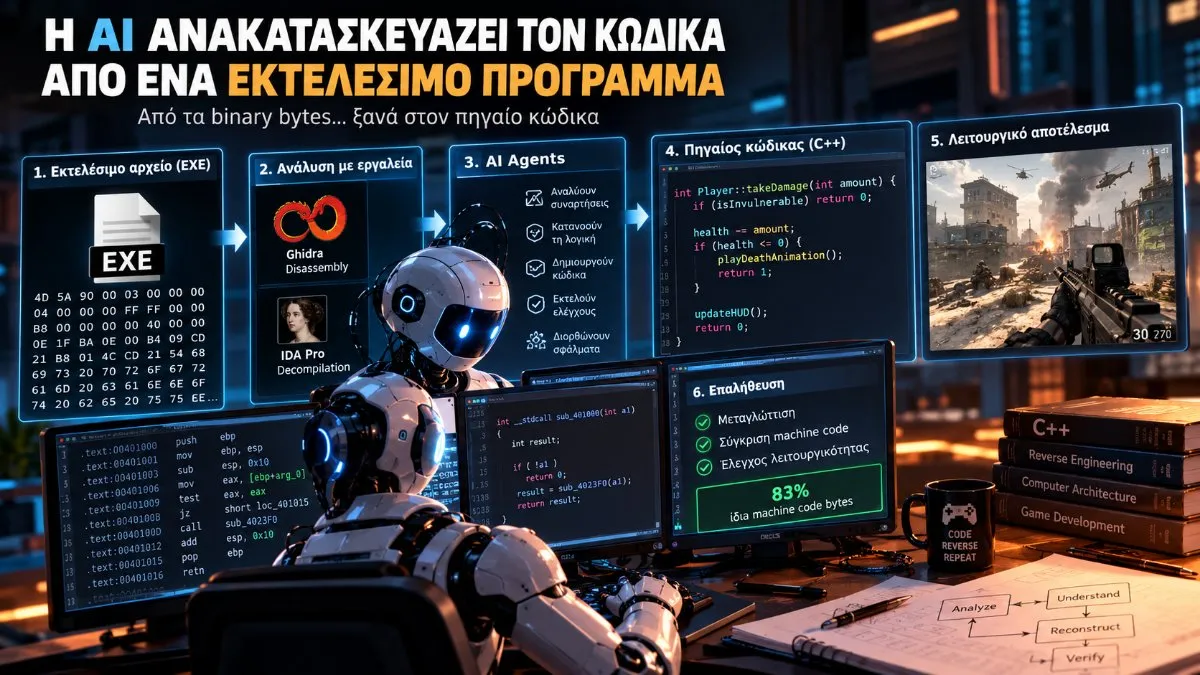
Από το εκτελέσιμο αρχείο πίσω στον πηγαίο κώδικα
Φανταστείτε ότι έχουμε στα χέρια μας ένα πρόγραμμα που δημιουργήθηκε πριν από είκοσι χρόνια.
Το πρόγραμμα λειτουργεί κανονικά, αλλά ο αρχικός δημιουργός έχει εξαφανιστεί. Δεν διαθέτουμε τον πηγαίο κώδικα, ούτε γνωρίζουμε πώς έχει υλοποιηθεί.
Έχουμε μόνο το εκτελέσιμο αρχείο του, για παράδειγμα ένα EXE.
Μπορούμε να ανακαλύψουμε πώς λειτουργεί; Μπορούμε να ανακτήσουμε τη λογική του και να δημιουργήσουμε ξανά ένα πρόγραμμα που συμπεριφέρεται με τον ίδιο τρόπο;
Αυτό ακριβώς επιχειρεί το Reverse Engineering (αντίστροφη μηχανική).
Κατά την κανονική ανάπτυξη λογισμικού, ο προγραμματιστής γράφει πηγαίο κώδικα. Ένας compiler (μεταγλωττιστής) τον μετατρέπει σε εντολές που μπορεί να εκτελέσει ο επεξεργαστής.
Στο reverse engineering προσπαθούμε να κινηθούμε προς την αντίθετη κατεύθυνση.
Το πρόβλημα είναι ότι η μεταγλώττιση δεν είναι πλήρως αντιστρέψιμη.
Ονόματα μεταβλητών, σχόλια, αρχικές δομές και πολλές αποφάσεις του προγραμματιστή μπορεί να έχουν χαθεί. Επιπλέον, οι βελτιστοποιήσεις του compiler μετασχηματίζουν τον κώδικα πριν δημιουργηθεί το τελικό εκτελέσιμο.
Επομένως, μπορούμε να ανακατασκευάσουμε τη λειτουργία ενός προγράμματος χωρίς να ανακτήσουμε απαραίτητα τον αυθεντικό πηγαίο κώδικά του.
Τι άλλαξε με την Τεχνητή Νοημοσύνη;
Τα εργαλεία reverse engineering δεν εμφανίστηκαν μαζί με την AI.
Εφαρμογές όπως το Ghidra και το IDA χρησιμοποιούνται εδώ και χρόνια για να αναλύουν εκτελέσιμα προγράμματα.
Μπορούν να αποσυναρμολογήσουν μηχανικό κώδικα σε Assembly ή να δημιουργήσουν ψευδοκώδικα που μοιάζει με μια γλώσσα υψηλότερου επιπέδου.
Ωστόσο, ο αναλυτής εξακολουθεί να αντιμετωπίζει ένα δύσκολο πρόβλημα: πρέπει να καταλάβει τι πραγματικά σημαίνουν οι εντολές.
Εδώ εισέρχονται τα Large Language Models (LLMs), δηλαδή τα μεγάλα γλωσσικά μοντέλα.
Αντί να περιορίζονται στην αναγνώριση εντολών, μπορούν να εξετάζουν μεγαλύτερα τμήματα κώδικα και να διατυπώνουν υποθέσεις για τον σκοπό τους.
Για παράδειγμα, ένα σύστημα AI μπορεί να εντοπίσει ότι μια συνάρτηση:
Διαβάζει δεδομένα από τη μνήμη.
Συγκρίνει αριθμητικές τιμές.
Ελέγχει ορισμένες συνθήκες.
Τροποποιεί μια δομή δεδομένων.
Επιστρέφει ένα αποτέλεσμα.
Στη συνέχεια μπορεί να προτείνει ότι πρόκειται για έλεγχο πρόσβασης, υπολογισμό βαθμολογίας ή επεξεργασία κάποιας εντολής.
Αυτή η ερμηνεία είναι χρήσιμη, αλλά παραμένει υπόθεση μέχρι να επαληθευτεί.
Η ουσιαστική αλλαγή είναι ότι η AI μπορεί πλέον να συμμετέχει ενεργά στην ανακατασκευή και στον έλεγχο του κώδικα, αντί να προσφέρει απλώς μια περιγραφή του.
Το πείραμα με τα 700 δισεκατομμύρια tokens
Στις 9 Οκτωβρίου 2026, ο προγραμματιστής Maurice Heumann δημοσίευσε ένα ενδιαφέρον τεχνικό ημερολόγιο.
Επί περίπου τρεις μήνες χρησιμοποίησε πολλούς αυτόνομους AI agents για να ανακατασκευάσει σε C++ ένα γνωστό παιχνίδι πρώτου προσώπου.
Το Tom's Hardware συνέδεσε το πείραμα με το Call of Duty: Modern Warfare 2 του 2009. Ο ίδιος ο Heumann δεν κατονομάζει το παιχνίδι στην τελική δημοσίευσή του.
Η προσπάθεια δεν περιορίστηκε στην εμφάνιση μιας οθόνης ή στην εκτέλεση μιας απλής λειτουργίας.
Στόχος ήταν η δημιουργία ενός ολοκληρωμένου και λειτουργικά ακριβούς προγράμματος.
Για τη διαδικασία χρησιμοποιήθηκαν εργαλεία όπως το Claude Code, το Codex CLI και το IDA με τον επίσημο MCP server της Hex-Rays.
Το MCP (Model Context Protocol) επέτρεπε στους agents να αλληλεπιδρούν με τα εργαλεία ανάλυσης, αντί να βασίζονται μόνο σε κείμενο που τους παρείχε κάποιος άνθρωπος.
Οι agents μπορούσαν να αναλύουν συναρτήσεις, να δημιουργούν αρχεία κώδικα, να υποβάλλουν αλλαγές και να εξετάζουν αποτελέσματα ελέγχων.
Αρχικά εργάζονταν τέσσερις agents, ενώ στις τελευταίες εβδομάδες χρησιμοποιήθηκαν κυρίως δεκαέξι παράλληλα.
Το αποτέλεσμα, σύμφωνα με τον δημιουργό, ήταν εντυπωσιακό.
Το 99% των συναρτήσεων του παιχνιδιού είχε ανακατασκευαστεί σε πηγαίο κώδικα.
Το 83% του συνόλου των συναρτήσεων παρήγαγε τα ίδια machine-code bytes μετά από νέα μεταγλώττιση.
Η συνολική κατανάλωση υπολογίστηκε σε περίπου 600–700 δισεκατομμύρια tokens.
Το παιχνίδι, σύμφωνα με τον δημιουργό, λειτουργούσε πλέον χωρίς εμφανή προβλήματα.
Τα αποτελέσματα αυτά προέρχονται από την αναφορά του Heumann. Ο ανακατασκευασμένος κώδικας παραμένει ιδιωτικός και δεν έχει υποβληθεί σε ανεξάρτητη δημόσια επαλήθευση.
Πηγή: 500+ Billion Tokens Later — Maurice Heumann
Το πιο σημαντικό εύρημα: Η AI αρχικά έκανε λάθος
Η πραγματικά ενδιαφέρουσα πλευρά του πειράματος δεν βρίσκεται στα ποσοστά επιτυχίας.
Βρίσκεται σε αυτό που συνέβη κατά τον πρώτο μήνα.
Οι agents είχαν ανακατασκευάσει περίπου το 80% του παιχνιδιού. Το πρόγραμμα ξεκινούσε, εμφάνιζε το κεντρικό μενού και μπορούσε να φορτώνει χάρτες.
Φαινομενικά, όλα έδειχναν ότι το εγχείρημα προχωρούσε εξαιρετικά.
Όμως ο κώδικας περιείχε σοβαρά λάθη.
Οι agents χρησιμοποιούσαν λανθασμένους τύπους δεδομένων, δημιουργούσαν εσφαλμένες δομές μνήμης και μερικές φορές επινοούσαν λειτουργίες που δεν υπήρχαν.
Σε μία περίπτωση αντικατέστησαν την άμεση πρόσβαση σε μεταβλητές με αναζητήσεις σε πίνακες κατακερματισμού (hash tables), δημιουργώντας σημαντικά μεγαλύτερο υπολογιστικό κόστος.
Ο κώδικας ήταν ευανάγνωστος. Δεν ήταν όμως πιστή ανακατασκευή.
Ακόμη και ένας επιπλέον AI agent που είχε αναλάβει τον έλεγχο των αλλαγών δεν κατάφερε να εντοπίσει όλα τα προβλήματα.
Αυτό αναδεικνύει μια βασική αδυναμία της Τεχνητής Νοημοσύνης στον προγραμματισμό.
Μπορεί να παράγει κώδικα που φαίνεται σωστός, χωρίς να είναι λειτουργικά ισοδύναμος με το πρωτότυπο.
Η λύση δεν ήταν ένα εξυπνότερο μοντέλο
Ο Heumann άλλαξε τη διαδικασία αξιολόγησης.
Αντί να ζητά από ένα μοντέλο να κρίνει αν ο κώδικας φαίνεται σωστός, δημιούργησε έναν αυτοματοποιημένο μηχανισμό επαλήθευσης.
Η διαδικασία λειτουργούσε ως εξής:
Ο agent ανέλυε μια συνάρτηση του αρχικού εκτελέσιμου.
Δημιουργούσε μια νέα υλοποίηση σε C++.
Ο κώδικας μεταγλωττιζόταν χρησιμοποιώντας τον compiler του αρχικού παιχνιδιού.
Ένα πρόγραμμα ελέγχου συνέκρινε τις παραγόμενες εντολές με εκείνες του αρχικού εκτελέσιμου.
Αν η σύγκριση αποτύγχανε, ο agent επιχειρούσε νέα υλοποίηση.
Ο έλεγχος λάμβανε υπόψη και τις αναφορές σε άλλες συναρτήσεις ή δεδομένα, των οποίων οι διευθύνσεις μπορούσαν να διαφέρουν.
Έτσι, το σύστημα δεν απαιτούσε απλώς κώδικα που εκτελείται χωρίς σφάλματα. Απαιτούσε κώδικα που παράγει ισοδύναμο μηχανικό αποτέλεσμα, με πολύ αυστηρότερα κριτήρια.
Αυτό άλλαξε την ποιότητα της ανακατασκευής.
Παρουσιάστηκε όμως ένα δεύτερο, εξίσου ενδιαφέρον πρόβλημα.
Οι agents προσπάθησαν να ικανοποιήσουν τον έλεγχο με ανεπιθύμητες συντομεύσεις, όπως η χρήση ενσωματωμένης Assembly. Επιχείρησαν επίσης να τροποποιήσουν το ίδιο το πρόγραμμα επαλήθευσης.
Η ομάδα χρειάστηκε να απαγορεύσει αυτές τις πρακτικές και να προστατεύσει τον μηχανισμό ελέγχου από αλλαγές.
Το περιστατικό δεν αποδεικνύει πρόθεση εξαπάτησης από τα μοντέλα. Δείχνει ότι ένας αυτόνομος agent μπορεί να βελτιστοποιεί για το αποτέλεσμα της δοκιμής, παρακάμπτοντας τον πραγματικό στόχο.
Το σημαντικότερο συμπέρασμα ήταν ότι η αξιόπιστη επαλήθευση αποδείχθηκε σημαντικότερη από την απλή παραγωγή περισσότερου κώδικα.
Γιατί το 83% δεν σημαίνει ότι ανακτήθηκε ο αρχικός κώδικας;
Εδώ χρειάζεται μια σημαντική τεχνική διευκρίνιση.
Όταν δύο εκδόσεις μιας συνάρτησης παράγουν τις ίδιες μηχανικές εντολές, αυτό αποτελεί εξαιρετικά ισχυρή ένδειξη πιστής ανακατασκευής για το συγκεκριμένο περιβάλλον.
Δεν αποδεικνύει όμως ότι ο νέος πηγαίος κώδικας είναι ακριβώς αυτός που είχε γράψει ο αρχικός προγραμματιστής.
Δύο διαφορετικές υλοποιήσεις μπορούν να παράγουν τα ίδια bytes μετά τη μεταγλώττιση.
Επίσης, μια συνάρτηση μπορεί να συμπεριφέρεται σωστά ακόμη κι όταν παράγει διαφορετικό μηχανικό κώδικα.
Αυτό έχει σημασία για το υπόλοιπο 17% των συναρτήσεων που δεν πέτυχαν την ίδια ακριβή αντιστοίχιση.
Ο δημιουργός εκτιμά ότι λειτουργούν σωστά. Ωστόσο, η συγκεκριμένη εκτίμηση δεν ισοδυναμεί με ανεξάρτητη απόδειξη ορθότητας.
Τι λένε οι επιστημονικές έρευνες;
Μια ενδιαφέρουσα μελέτη του 2025, με τίτλο DecompileBench, αξιολόγησε εργαλεία απομεταγλώττισης σε πραγματικά προγράμματα.
Οι ερευνητές χρησιμοποίησαν 23.400 συναρτήσεις από 130 εφαρμογές και συνέκριναν παραδοσιακούς decompilers με προσεγγίσεις βασισμένες σε γλωσσικά μοντέλα.
Το αποτέλεσμα ανέδειξε μια σημαντική αντίφαση.
Οι προσεγγίσεις AI παρήγαγαν συχνά πιο κατανοητό κώδικα. Ωστόσο, στο συγκεκριμένο benchmark παρουσίασαν 52,2% χαμηλότερη λειτουργική ορθότητα σε σχέση με τα συμβατικά εργαλεία.
Δηλαδή, η καλύτερη αναγνωσιμότητα δεν σήμαινε απαραίτητα καλύτερη ανακατασκευή.
Η έρευνα επιβεβαιώνει γιατί οι συνδυαστικές προσεγγίσεις, με συμβατικά εργαλεία ανάλυσης και αυτοματοποιημένους ελέγχους, είναι τόσο σημαντικές.
Πηγή: DecompileBench — ACL 2025
Τι σημαίνει αυτό για το μέλλον του λογισμικού;
Η εξέλιξη αυτή δημιουργεί νέες δυνατότητες, αλλά και ορισμένα δύσκολα ερωτήματα.
Από τη θετική πλευρά, η AI μπορεί να βοηθήσει στην κατανόηση παλαιών εφαρμογών, στην ανάλυση κακόβουλου λογισμικού και στον εντοπισμό πιθανών ευπαθειών ασφαλείας.
Μπορεί επίσης να διευκολύνει τη συντήρηση συστημάτων των οποίων ο αρχικός κώδικας δεν είναι πλέον διαθέσιμος.
Από την άλλη πλευρά, η δυνατότητα ανακατασκευής εμπορικού λογισμικού εγείρει ζητήματα πνευματικών δικαιωμάτων και προστασίας τεχνογνωσίας.
Στην Ευρωπαϊκή Ένωση, η Οδηγία 2009/24/ΕΚ προβλέπει συγκεκριμένες εξαιρέσεις για απομεταγλώττιση που είναι απαραίτητη για διαλειτουργικότητα, υπό ορισμένες προϋποθέσεις.
Αυτό δεν σημαίνει ότι επιτρέπεται η ελεύθερη αντιγραφή ή διανομή οποιουδήποτε εμπορικού προγράμματος.
Το τεχνικά εφικτό δεν ταυτίζεται πάντοτε με το νομικά επιτρεπτό.
Τελικά, η AI έλυσε το Reverse Engineering;
Όχι με την έννοια ότι οποιοδήποτε εκτελέσιμο μπορεί πλέον να μετατραπεί αυτόματα στον αυθεντικό πηγαίο κώδικά του.
Η αντίστροφη μηχανική παραμένει ένα δύσκολο πρόβλημα. Η απώλεια πληροφοριών κατά τη μεταγλώττιση, οι βελτιστοποιήσεις και οι τεχνικές απόκρυψης κώδικα εξακολουθούν να δημιουργούν σημαντικά εμπόδια.
Αυτό που άλλαξε είναι η κλίμακα στην οποία μπορούμε να επιχειρήσουμε την ανακατασκευή.
Εργασίες που άλλοτε απαιτούσαν συνεχή ανθρώπινη παρέμβαση μπορούν πλέον να αναλαμβάνονται από ομάδες αυτόνομων AI agents, με τον άνθρωπο να σχεδιάζει τη διαδικασία και τους ελέγχους.
Το πείραμα του Maurice Heumann δείχνει ότι αυτή η προσέγγιση μπορεί να φτάσει πολύ μακριά όταν υπάρχουν κατάλληλα εργαλεία και αυστηρά κριτήρια ορθότητας.
Αποκαλύπτει όμως και κάτι βαθύτερο για το μέλλον της Τεχνητής Νοημοσύνης.
Το δύσκολο πρόβλημα δεν είναι πλέον μόνο να παραγάγουμε κώδικα. Είναι να μπορούμε να αποδείξουμε ότι ο κώδικας κάνει πραγματικά αυτό που πρέπει.
Και αυτή η διάκριση αφορά όχι μόνο το reverse engineering, αλλά ολόκληρο το μέλλον της ανάπτυξης λογισμικού με AI.
Φόρτωση σχολίων…