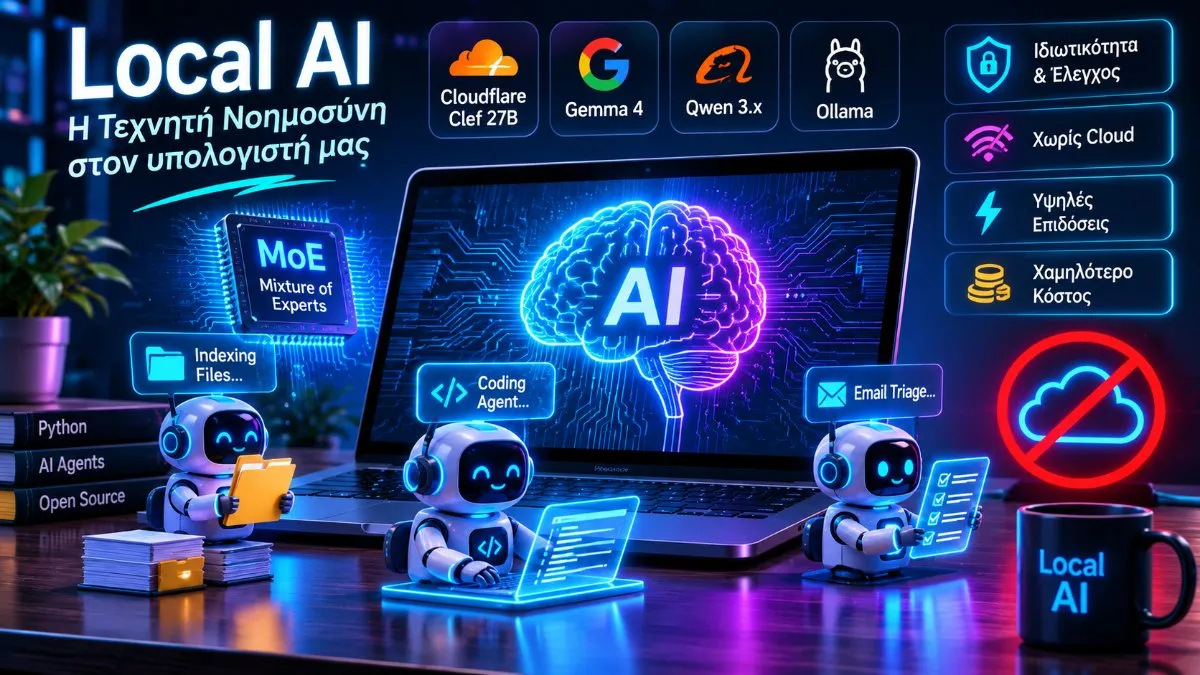
1. Cloudflare Clef 27B: Ένα AI που δεν γράφει απαντήσεις, αλλά παίρνει αποφάσεις
Την 1η Οκτωβρίου 2026, η Cloudflare παρουσίασε τα Clef και Clef-flash, μια νέα οικογένεια μοντέλων Τεχνητής Νοημοσύνης.
Στις 19 Οκτωβρίου, το Clef έγινε διαθέσιμο και μέσω του Ollama, προσφέροντας τη δυνατότητα εκτέλεσης στον προσωπικό υπολογιστή ή στο cloud.
Το Clef 27B διαθέτει περίπου 27 δισεκατομμύρια παραμέτρους και βασίζεται στο Qwen3.8-27B. Διατίθεται με ανοιχτά βάρη και άδεια Apache 2.0.
Η σημαντικότερη διαφορά του από ένα συνηθισμένο Large Language Model (LLM) βρίσκεται στον σκοπό του.
Ένα παραδοσιακό LLM παράγει κείμενο, δημιουργώντας διαδοχικά τις λέξεις ή τα τμήματα λέξεων της απάντησης.
Το Clef λειτουργεί διαφορετικά. Είναι ένα decision model, δηλαδή ένα μοντέλο σχεδιασμένο να αξιολογεί πληροφορίες και να επιστρέφει συγκεκριμένες αποφάσεις.
Αντί να γράφει μια μεγάλη εξήγηση, μπορεί να επιλέγει ανάμεσα σε προκαθορισμένες απαντήσεις και να επιστρέφει βαθμολογίες πιθανότητας.
Ένα πρακτικό παράδειγμα
Ας υποθέσουμε ότι μια επιχείρηση λαμβάνει καθημερινά εκατοντάδες αιτήματα υποστήριξης.
Ένα AI σύστημα πρέπει να αποφασίζει αν κάθε αίτημα αφορά τεχνικό πρόβλημα, οικονομική εκκρεμότητα ή γενική πληροφορία.
Με ένα παραδοσιακό LLM, η εφαρμογή θα μπορούσε να ζητήσει μια απάντηση σε μορφή JSON και στη συνέχεια να την αναλύσει.
Το Clef μπορεί να αξιολογήσει απευθείας τις πιθανές κατηγορίες και να επιστρέψει τις σχετικές βαθμολογίες.
Αυτή η προσέγγιση είναι ιδιαίτερα χρήσιμη για εργασίες όπως:
Ταξινόμηση εγγράφων και εισερχόμενων αιτημάτων.
Επιλογή της κατάλληλης υπηρεσίας για ένα API request.
Ανάλυση εικόνων, αποδείξεων και φορμών.
Αξιολόγηση κανόνων και πολιτικών.
Έλεγχο ενεργειών που προτείνουν άλλοι AI Agents.
Το μοντέλο δεν περιορίζεται στο κείμενο, καθώς μπορεί να αξιολογεί και εικόνες. Στις 9 Οκτωβρίου, η Cloudflare παρουσίασε επίσης το Clef-omni, επεκτείνοντας την οικογένεια σε ήχο και βίντεο.
Η ουσιαστική αλλαγή είναι ότι δεν χρειάζεται κάθε εργασία Τεχνητής Νοημοσύνης ένα μεγάλο μοντέλο παραγωγής κειμένου.
Ορισμένες εφαρμογές χρειάζονται απλώς μια γρήγορη, δομημένη και αξιοποιήσιμη απόφαση.
2. Mixture of Experts: Πώς τα μεγάλα μοντέλα γίνονται αποδοτικότερα
Μια δεύτερη σημαντική εξέλιξη αφορά την αρχιτεκτονική των ίδιων των μοντέλων.
Τα περισσότερα παραδοσιακά μοντέλα βασίζονται στην αρχιτεκτονική Dense, όπου μεγάλο μέρος των παραμέτρων συμμετέχει στους υπολογισμούς για κάθε token.
Το token αποτελεί τη βασική μονάδα επεξεργασίας κειμένου ενός γλωσσικού μοντέλου.
Στην αρχιτεκτονική Mixture of Experts (MoE), το μοντέλο χωρίζεται σε επιμέρους εξειδικευμένα τμήματα, γνωστά ως experts.
Ένας μηχανισμός επιλογής ενεργοποιεί μόνο ένα μέρος τους για κάθε token, μειώνοντας τον απαραίτητο υπολογισμό.
Το παράδειγμα του Qwen3.5-35B-A3B
Το Qwen3.5-35B-A3B διαθέτει περίπου 35 δισεκατομμύρια συνολικές παραμέτρους.
Ωστόσο, για την επεξεργασία κάθε token ενεργοποιούνται περίπου 3 δισεκατομμύρια παράμετροι.
Αυτό επιτρέπει στο μοντέλο να αξιοποιεί την εξειδίκευση ενός μεγαλύτερου δικτύου, χωρίς να εκτελεί όλους τους υπολογισμούς κάθε φορά.
Αντίστοιχη προσέγγιση ακολουθεί το NVIDIA Nemotron 3.5 Lightning, με 30 δισεκατομμύρια συνολικές και περίπου 3 δισεκατομμύρια ενεργές παραμέτρους.
Πρέπει, ωστόσο, να γίνει μια σημαντική διευκρίνιση.
Λιγότερες ενεργές παράμετροι δεν σημαίνουν ότι το μοντέλο χρειάζεται μνήμη μόνο για αυτές.
Τα βάρη των υπόλοιπων experts εξακολουθούν να πρέπει να αποθηκεύονται στη RAM ή στη VRAM, ή να μεταφέρονται όταν χρειάζονται.
Επομένως, ένας υπολογιστής με 16GB μνήμης δεν μπορεί απαραίτητα να εκτελέσει αποτελεσματικά οποιοδήποτε μοντέλο MoE των 35B.
Η πραγματική απαίτηση εξαρτάται από την κβαντοποίηση, το μέγεθος του context και την υλοποίηση της μηχανής inference.
Παρόλα αυτά, τα MoE αποτελούν σημαντικό βήμα για την αποδοτικότερη αξιοποίηση του διαθέσιμου hardware.
3. Gemma 4 και Qwen: Ισχυρότερα μοντέλα χωρίς υποχρεωτική σύνδεση στο cloud
Η Google και η Alibaba συνεχίζουν να επενδύουν σε οικογένειες μοντέλων με δυνατότητα τοπικής εκτέλεσης.
Η Google παρουσίασε την οικογένεια Gemma 4 την άνοιξη του 2026, με εκδόσεις για διαφορετικές κατηγορίες συσκευών.
Τα μικρότερα μοντέλα μπορούν να αξιοποιηθούν σε εφαρμογές περιορισμένων πόρων, ενώ οι μεγαλύτερες εκδόσεις προορίζονται για πιο απαιτητικές εργασίες.
Ιδιαίτερο ενδιαφέρον παρουσιάζει το Gemma 4 12B, που κυκλοφόρησε τον Ιούνιο και υποστηρίζει κείμενο, εικόνα και ήχο.
Από την άλλη πλευρά, η οικογένεια Qwen προσφέρει μοντέλα διαφορετικών μεγεθών, με δυνατότητες reasoning, multimodal επεξεργασίας και χρήσης εργαλείων.
Για έναν προγραμματιστή, αυτό σημαίνει ότι ο ίδιος υπολογιστής μπορεί να χρησιμοποιηθεί για διαφορετικούς σκοπούς.
Ένα μικρό μοντέλο μπορεί να ταξινομεί τοπικά αρχεία, ενώ ένα μεγαλύτερο μπορεί να αναλύει κώδικα ή να εκτελεί σύνθετες εργασίες.
Το σημαντικότερο είναι ότι αυτές οι δυνατότητες δεν απαιτούν υποχρεωτικά την αποστολή του περιεχομένου σε απομακρυσμένη υπηρεσία.
4. Ollama και llama.cpp: Το Local AI γίνεται πιο προσβάσιμο
Η αυξανόμενη διαθεσιμότητα μοντέλων δεν θα είχε την ίδια αξία χωρίς εργαλεία που διευκολύνουν την εκτέλεσή τους.
Το Ollama αποτελεί μία από τις δημοφιλείς επιλογές για την εγκατάσταση και λειτουργία μοντέλων Τεχνητής Νοημοσύνης σε προσωπικούς υπολογιστές.
Μέσα στο 2026, η πλατφόρμα απέκτησε σημαντικές βελτιώσεις στην υποστήριξη hardware και μορφών μοντέλων.
GGUF: Περισσότερα μοντέλα, λιγότερες διαδικασίες
Το GGUF είναι μια μορφή αποθήκευσης μοντέλων, ιδιαίτερα διαδεδομένη στο οικοσύστημα του llama.cpp.
Υποστηρίζει κβαντοποίηση (quantization), δηλαδή αναπαράσταση των βαρών με μικρότερη αριθμητική ακρίβεια για περιορισμό των απαιτήσεων μνήμης.
Με την ενσωμάτωση του llama.cpp στο Ollama 0.30, διευρύνθηκε η συμβατότητα με διαφορετικά GGUF μοντέλα.
Παράλληλα, η σύνδεση με το Hugging Face επιτρέπει την εκτέλεση συμβατών μοντέλων απευθείας από τα αποθετήριά τους.
Για παράδειγμα, η εντολή:
ollama run hf.co/username/repository
επιτρέπει τη λήψη και εκτέλεση ενός διαθέσιμου GGUF μοντέλου, χωρίς να χρειάζεται ο χρήστης να δημιουργήσει χειροκίνητα ένα Modelfile.
Η δυνατότητα αυτή διευκολύνει σημαντικά τους developers που πειραματίζονται με διαφορετικά μοντέλα.
Vulkan: Περισσότερες επιλογές για AMD και Intel
Μια ιδιαίτερα χρήσιμη εξέλιξη ήρθε τον Ιούνιο του 2026 με το Ollama 0.30.
Η υποστήριξη Vulkan ενεργοποιήθηκε από προεπιλογή, επεκτείνοντας τις δυνατότητες επιτάχυνσης σε περισσότερες κάρτες γραφικών.
Το Vulkan είναι ένα API που επιτρέπει σε εφαρμογές να αξιοποιούν τις υπολογιστικές δυνατότητες συμβατών GPUs.
Για χρήστες με AMD ή Intel hardware, αυτό σημαίνει περισσότερες πιθανότητες αξιοποίησης της GPU χωρίς εξειδικευμένες εγκαταστάσεις.
Η απόδοση εξακολουθεί να εξαρτάται από τη συσκευή, τους drivers και την υποστήριξη κάθε μοντέλου.
Multi-Token Prediction: Ταχύτερη παραγωγή κώδικα
Μια ακόμη εξέλιξη αφορά την τεχνική Multi-Token Prediction (MTP).
Αντί το σύστημα να υπολογίζει υποχρεωτικά κάθε νέο token ξεχωριστά, ένα μικρότερο μοντέλο προτείνει περισσότερα tokens ταυτόχρονα.
Το κύριο μοντέλο επαληθεύει τις προτάσεις και αποδέχεται όσες είναι συμβατές με τη δική του πρόβλεψη.
Στις 29 Ιουνίου 2026, το Ollama ανακοίνωσε ότι η τεχνική βελτίωσε σημαντικά την απόδοση του Gemma 4 σε Apple Silicon.
Στις συγκεκριμένες δοκιμές με coding agents, η ταχύτητα παραγωγής tokens αυξήθηκε κατά περίπου 90% κατά μέσο όρο.
Το ποσοστό αφορά το συγκεκριμένο benchmark και δεν αποτελεί γενική εγγύηση αντίστοιχης βελτίωσης σε κάθε υπολογιστή.
5. Local Coding Agents: Από την παραγωγή κώδικα στην εκτέλεση εργασιών
Η πιο ενδιαφέρουσα εξέλιξη ίσως δεν αφορά τα ίδια τα μοντέλα, αλλά τον τρόπο αξιοποίησής τους.
Μέχρι πρόσφατα, πολλοί χρήστες αντιμετώπιζαν το Local AI ως μια απλή εφαρμογή συνομιλίας.
Έγραφαν μια ερώτηση, λάμβαναν απάντηση και στη συνέχεια εκτελούσαν μόνοι τους τις απαραίτητες ενέργειες.
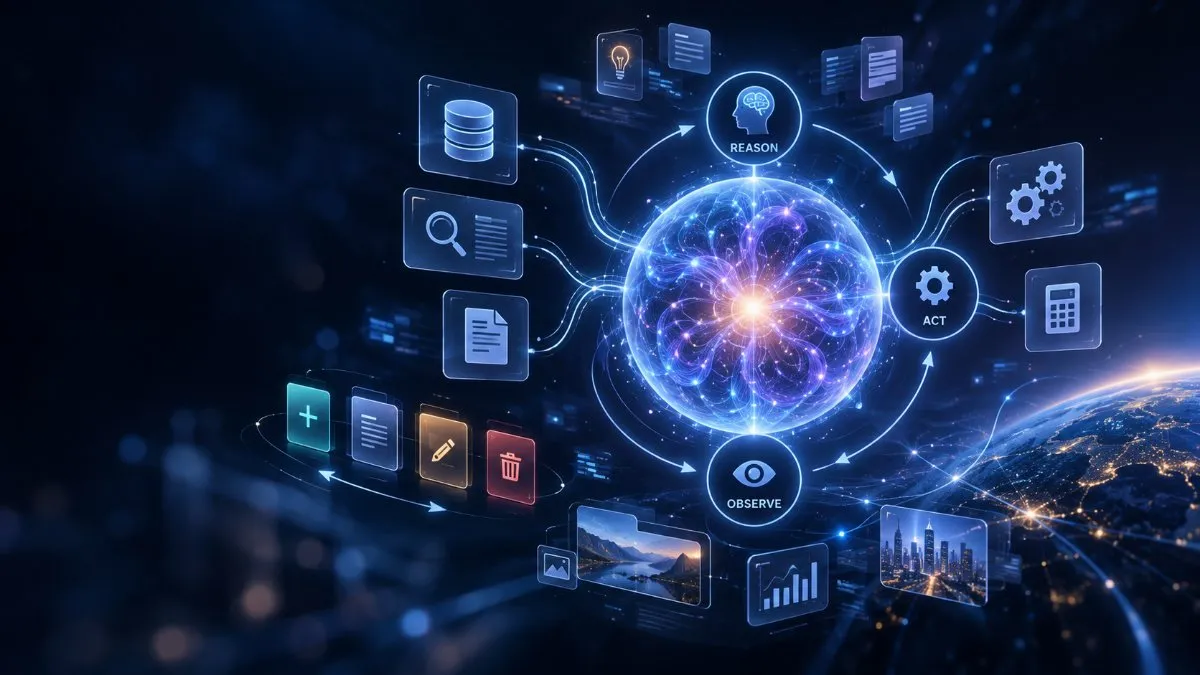
Οι AI Coding Agents αλλάζουν αυτή τη διαδικασία.
Ένας agent μπορεί, με τα κατάλληλα εργαλεία και δικαιώματα, να διαβάζει αρχεία ενός project, να προτείνει τροποποιήσεις και να εκτελεί δοκιμές.
Το Ollama διαθέτει συμβατότητα με το Anthropic Messages API και υποστηρίζει ενσωματώσεις με εργαλεία όπως Claude Code, Codex και OpenCode.
Μέσω της εντολής ollama launch, ο χρήστης μπορεί να συνδέσει συμβατούς coding agents με τοπικά ή cloud μοντέλα.
Για παράδειγμα, η εντολή:
ollama launch claude
ξεκινά τη διαδικασία σύνδεσης του Claude Code με ένα μοντέλο που εξυπηρετείται μέσω Ollama.
Αξίζει να διευκρινιστεί ότι το μοντέλο δεν αποκτά αυτόματα ανεξέλεγκτη πρόσβαση στον υπολογιστή.
Οι ενέργειες, όπως η εκτέλεση εντολών ή η τροποποίηση αρχείων, πραγματοποιούνται από την εφαρμογή που φιλοξενεί τον agent.
Αυτό καθιστά ιδιαίτερα σημαντική τη σωστή διαχείριση δικαιωμάτων, την απομόνωση του περιβάλλοντος και την επιβεβαίωση κρίσιμων ενεργειών.
6. Micro-Agents: Μικροί βοηθοί που λειτουργούν στον υπολογιστή μας
Πέρα από τους coding agents, αναπτύσσεται ένα νέο μοντέλο εφαρμογών που βασίζεται σε μικρότερους, εξειδικευμένους AI βοηθούς.
Αντί ένας μεγάλος agent να αναλαμβάνει τα πάντα, διαφορετικοί βοηθοί μπορούν να αναλαμβάνουν συγκεκριμένες εργασίες.
Φανταστείτε ένα τοπικό σύστημα με τρεις ανεξάρτητους agents:
Έναν agent που οργανώνει και ευρετηριάζει τα αρχεία ενός υπολογιστή.
Έναν agent που ταξινομεί εισερχόμενα email, όταν έχει εξουσιοδοτημένη πρόσβαση.
Έναν agent που παρακολουθεί τοπικά logs και προετοιμάζει αναφορές για προβλήματα εφαρμογών.
Οι agents μπορούν να αξιοποιούν το ίδιο τοπικό μοντέλο ή διαφορετικά μοντέλα ανάλογα με τις απαιτήσεις τους.
Ένα πραγματικό παράδειγμα αυτής της κατεύθυνσης αποτελεί το OpenJarvis, ένα ανοιχτού κώδικα framework που παρουσιάστηκε τον Μάιο του 2026.
Το OpenJarvis επιτρέπει τη δημιουργία προσωπικών AI Agents με προτεραιότητα στην τοπική εκτέλεση και προαιρετική χρήση cloud.
Προσφέρει δυνατότητες έρευνας σε αρχεία, δημιουργίας ενημερωτικών αναφορών και εκτέλεσης εργασιών προγραμματισμού.
Η κατεύθυνση αυτή δείχνει πώς το Local AI μπορεί να εξελιχθεί σε ένα επίπεδο αυτοματισμού ενσωματωμένο στην καθημερινή χρήση του υπολογιστή.
7. Είναι το Local AI πραγματικά δωρεάν και ιδιωτικό;
Δύο από τα σημαντικότερα επιχειρήματα υπέρ του Local AI είναι το κόστος και η προστασία δεδομένων.
Όταν ένα μοντέλο εκτελείται αποκλειστικά στον υπολογιστή, δεν χρειάζεται να πληρώνουμε υποχρεωτικά μια εξωτερική υπηρεσία για κάθε αίτημα.
Αυτό δεν σημαίνει ότι η λειτουργία είναι εντελώς δωρεάν.
Το hardware, η ηλεκτρική ενέργεια, η μνήμη και η συντήρηση του συστήματος εξακολουθούν να έχουν κόστος.
Αντίστοιχα, η τοπική εκτέλεση προσφέρει περισσότερο έλεγχο στα δεδομένα, αλλά δεν εγγυάται αυτόματα απόλυτη ιδιωτικότητα.
Ένας agent που συνδέεται σε email, διαδικτυακές υπηρεσίες ή εξωτερικά APIs μπορεί να ανταλλάσσει δεδομένα μέσω δικτύου.
Η πραγματική προστασία εξαρτάται από τη συνολική αρχιτεκτονική, τα δικαιώματα πρόσβασης και τις υπηρεσίες που χρησιμοποιούνται.
Για εφαρμογές που επεξεργάζονται προσωπικά δεδομένα ή εμπιστευτικό κώδικα, αυτές οι λεπτομέρειες είναι εξίσου σημαντικές με την επιλογή του μοντέλου.
8. Τι σημαίνουν όλες αυτές οι εξελίξεις για έναν developer;
Η σημαντικότερη αλλαγή είναι ότι ο προγραμματιστής αποκτά περισσότερες επιλογές στον σχεδιασμό μιας εφαρμογής Τεχνητής Νοημοσύνης.
Δεν είναι πλέον απαραίτητο να χρησιμοποιεί ένα μεγάλο cloud μοντέλο για κάθε εργασία.
Μπορεί να αξιοποιήσει ένα μικρό τοπικό μοντέλο για ταξινόμηση, ένα μεγαλύτερο για παραγωγή κώδικα και μια εξωτερική υπηρεσία μόνο όταν απαιτείται.
Αυτό δημιουργεί μια υβριδική αρχιτεκτονική, στην οποία το Local AI και το Cloud AI λειτουργούν συμπληρωματικά.
Ένα τέτοιο σύστημα μπορεί να περιορίσει τα επαναλαμβανόμενα API requests, να μειώσει ορισμένες καθυστερήσεις και να προσφέρει καλύτερο έλεγχο των δεδομένων.
Παράλληλα, απαιτεί προσεκτική επιλογή μοντέλων, μετρήσεις απόδοσης και σωστό σχεδιασμό ασφάλειας.
Συμπέρασμα: Το μέλλον της AI δεν βρίσκεται αποκλειστικά στο cloud
Η εξέλιξη του Local AI δεν σημαίνει ότι οι υπηρεσίες cloud πρόκειται να εξαφανιστούν.
Τα μεγαλύτερα μοντέλα εξακολουθούν να απαιτούν τεράστια υπολογιστική ισχύ, ενώ πολλές εφαρμογές χρειάζονται δυνατότητες που δεν είναι πρακτικό να λειτουργούν τοπικά.
Ωστόσο, η τεχνολογία αλλάζει την ισορροπία ανάμεσα στον προσωπικό υπολογιστή και στις απομακρυσμένες υπηρεσίες.
Το Clef δείχνει την αξία των εξειδικευμένων μοντέλων αποφάσεων. Οι αρχιτεκτονικές MoE βελτιώνουν την υπολογιστική αποδοτικότητα, ενώ το Ollama μειώνει τα εμπόδια στην τοπική εκτέλεση.
Την ίδια στιγμή, οι AI Agents μετατρέπουν αυτά τα μοντέλα από εργαλεία παραγωγής απαντήσεων σε συστήματα που μπορούν να συμμετέχουν ενεργά στις καθημερινές εργασίες.
Το πραγματικό ενδιαφέρον του Local AI δεν είναι απλώς ότι μπορούμε να συνομιλούμε με ένα μοντέλο χωρίς σύνδεση στο διαδίκτυο. Είναι ότι μπορούμε να δημιουργούμε εφαρμογές Τεχνητής Νοημοσύνης που λειτουργούν στο δικό μας hardware, με περισσότερη αυτονομία και έλεγχο.
Και αυτή είναι μια αλλαγή που αξίζει να παρακολουθήσουμε.
Φόρτωση σχολίων…