Από το data center στο desktop
Στις 15 Οκτωβρίου 2026, η NVIDIA ανακοίνωσε το Nemotron 3.5 Super VL και δύο εκδόσεις Nemotron 3.5 Bolt. Ο κοινός τους στόχος είναι να κάνουν τους AI agents αποτελεσματικότερους, από μεγάλα εταιρικά συστήματα έως υπολογιστές και συσκευές περιορισμένης μνήμης.
Ένας AI agent δεν περιορίζεται στο να απαντήσει σε μία ερώτηση. Μπορεί, όταν έχει συνδεθεί με τα κατάλληλα εργαλεία, να αναζητήσει πληροφορίες, να ανοίξει έγγραφα, να εκτελέσει ενέργειες και να αξιολογήσει τα αποτελέσματα. Όλα αυτά απαιτούν επαναλαμβανόμενες κλήσεις στο μοντέλο, χρόνο και υπολογιστικούς πόρους.
Η NVIDIA επιχειρεί να μειώσει αυτό το κόστος, συνδυάζοντας μεγάλα μοντέλα με τεχνικές που χρησιμοποιούν λιγότερη μνήμη και επιταχύνουν την παραγωγή απαντήσεων.
Τρία μοντέλα για διαφορετικές ανάγκες
| Μοντέλο | Χαρακτηριστικά | Χρήση και διαθεσιμότητα |
|---|---|---|
| Nemotron 3.5 Super VL | 120 δισ. παράμετροι, περίπου 12 δισ. ενεργές ανά token | Πολυτροπικοί agents για κείμενο, εικόνες, έγγραφα και βίντεο. Διαθέσιμο. |
| Nemotron 3.5 Bolt 74B-A9B | 74 δισ. παράμετροι, περίπου 9 δισ. ενεργές ανά token· ειδική έκδοση 24 GB | Τοπικοί agents για έρευνα, κώδικα και καθημερινές εργασίες. Διαθέσιμο. |
| Nemotron 3.5 Bolt E4B | Στόχος αποτυπώματος μνήμης 4 GB | Γρήγοροι συνομιλιακοί και edge agents. Προγραμματισμένη κυκλοφορία 23 Οκτωβρίου 2026. |
Το «4 GB» και το «24 GB» περιγράφουν στόχους μνήμης συγκεκριμένων εκδόσεων. Δεν σημαίνουν ότι οποιαδήποτε συσκευή με τόση συνολική μνήμη θα εκτελεί απρόσκοπτα κάθε εφαρμογή τους.
Τι σημαίνει Mixture of Experts;
Το Super VL διαθέτει 120 δισεκατομμύρια παραμέτρους. Αυτό όμως δεν σημαίνει ότι χρησιμοποιεί το σύνολό τους για κάθε κομμάτι κειμένου που επεξεργάζεται.
Η αρχιτεκτονική Mixture of Experts (MoE) οργανώνει μέρος του μοντέλου σε εξειδικευμένα υποδίκτυα, τους λεγόμενους experts. Ένας μηχανισμός επιλογής ενεργοποιεί μόνο τους απαραίτητους κάθε φορά. Στο Super VL, περίπου 12 δισεκατομμύρια παράμετροι συμμετέχουν στον υπολογισμό ανά token.
Έτσι περιορίζεται η υπολογιστική εργασία. Δεν περιορίζεται όμως αυτομάτως στο ίδιο μέγεθος η μνήμη που απαιτείται για την αποθήκευση των βαρών. Αυτός είναι ο λόγος που το Super VL δεν πρέπει να συγχέεται με το Bolt των 24 GB.
Super VL: Ένα μοντέλο που καταλαβαίνει και όσα βλέπει
Τα αρχικά VL σημαίνουν Vision-Language. Το Super VL συνδυάζει την επεξεργασία γλώσσας με την κατανόηση εικόνων, γραφημάτων, εγγράφων και καρέ βίντεο.
Στην πράξη, ένας agent μπορεί να εξετάσει ένα PDF, να διαβάσει έναν πίνακα, να συσχετίσει ένα γράφημα με το συνοδευτικό κείμενο και να δώσει τεκμηριωμένη απάντηση. Για έναν developer αυτό ανοίγει δυνατότητες σε αυτοματοποίηση εγγράφων, ελέγχους εφαρμογών και αναζήτηση σε ετερογενή δεδομένα.
Η NVIDIA αναφέρει επίσης υποστήριξη περιβάλλοντος έως 1 εκατομμύριο tokens. Πρόκειται για ανώτατη δυνατότητα του μοντέλου· η πραγματική διαθέσιμη χωρητικότητα εξαρτάται από τη μνήμη, τη ρύθμιση και το σύστημα εκτέλεσης.
Βίντεο: Η επίσημη παρουσίαση του Nemotron 3.5 Super VL
▶ Δείτε το επίσημο βίντεο της NVIDIA Developer
Το βίντεο παρουσιάζει παραδείγματα οπτικής ανάλυσης, όπως τον εντοπισμό κινδύνων σε ένα κατάστημα και την ερμηνεία γραφημάτων.
Πέντε φορές ταχύτερο; Τι μετρήθηκε πραγματικά
Σύμφωνα με τις μετρήσεις που δημοσίευσε η NVIDIA, το Super VL εμφάνισε έως και πενταπλάσιο throughput έναντι συγκεκριμένων συγκρινόμενων open-weight μοντέλων στην ίδια κατηγορία. Η σύγκριση αφορά συγκεκριμένο σενάριο αξιολόγησης με μεγάλο όγκο εισόδου, όχι όλες τις δυνατές εργασίες.
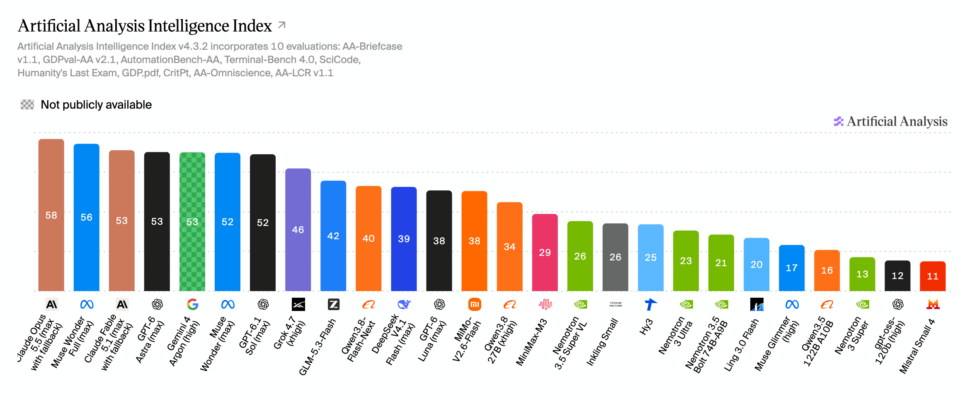
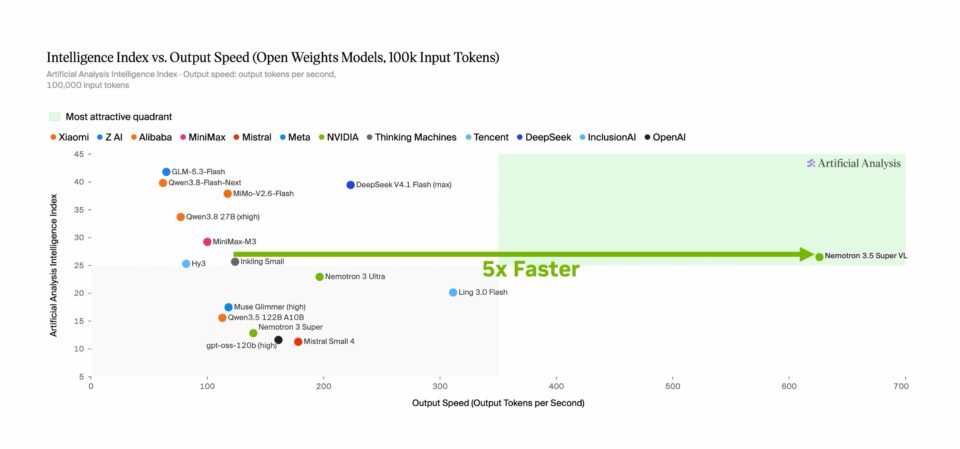
Γράφημα: NVIDIA / Artificial Analysis. Η απόδοση εξαρτάται από τη δοκιμή, τον εξοπλισμό και τον τρόπο εξυπηρέτησης των αιτημάτων.
Η ταχύτητα δημιουργίας tokens δεν είναι το ίδιο με την ποιότητα της τελικής απάντησης. Για να αξιολογήσουμε έναν πραγματικό agent πρέπει επίσης να μετρήσουμε την ακρίβεια, τις λανθασμένες ενέργειες, τις επαναλήψεις και τον χρόνο ολοκλήρωσης μιας ολόκληρης εργασίας.
Bolt 74B: Το σημαντικότερο νέο για όσους θέλουν local AI
Το Nemotron 3.5 Bolt 74B-A9B 24GB βασίζεται στο μεγαλύτερο Super VL, αλλά έχει υποστεί δομική συμπίεση και έντονη κβαντοποίηση περίπου 2 bit. Με απλά λόγια, αποθηκεύει τα βάρη του σε πολύ πιο περιορισμένη μορφή, ώστε η ειδική έκδοσή του να χωρά σε περίπου 24 GB.
Η NVIDIA αναφέρει επίδοση 84 tokens το δευτερόλεπτο σε δοκιμή AIPerf SPEED-Bench σε σύστημα RTX Spark. Αυτό είναι αποτέλεσμα συγκεκριμένης δοκιμής και δεν αποτελεί εγγυημένη ταχύτητα για κάθε GeForce ή laptop.
Φωτογραφία: NVIDIA — DGX Spark, ένα από τα συστήματα που υποστηρίζουν τη σειρά Nemotron.
Σύμφωνα με την ανακοίνωση, το Bolt υποστηρίζεται από οικοσυστήματα όπως Ollama, LM Studio, llama.cpp και vLLM. Αυτό το καθιστά ενδιαφέρον για developers που προτιμούν τον δικό τους εξοπλισμό αντί για κάθε αίτημα προς μια υπηρεσία cloud.
Όμως 24 GB για τα βάρη δεν σημαίνουν μηδενικές πρόσθετες απαιτήσεις. Η μνήμη για το context, η λειτουργία του συστήματος και άλλες εφαρμογές περιορίζουν το διαθέσιμο περιθώριο. Επιπλέον, οι βελτιστοποιήσεις της NVIDIA δεν συνεπάγονται ίδιες επιδόσεις σε υλικό άλλων κατασκευαστών.
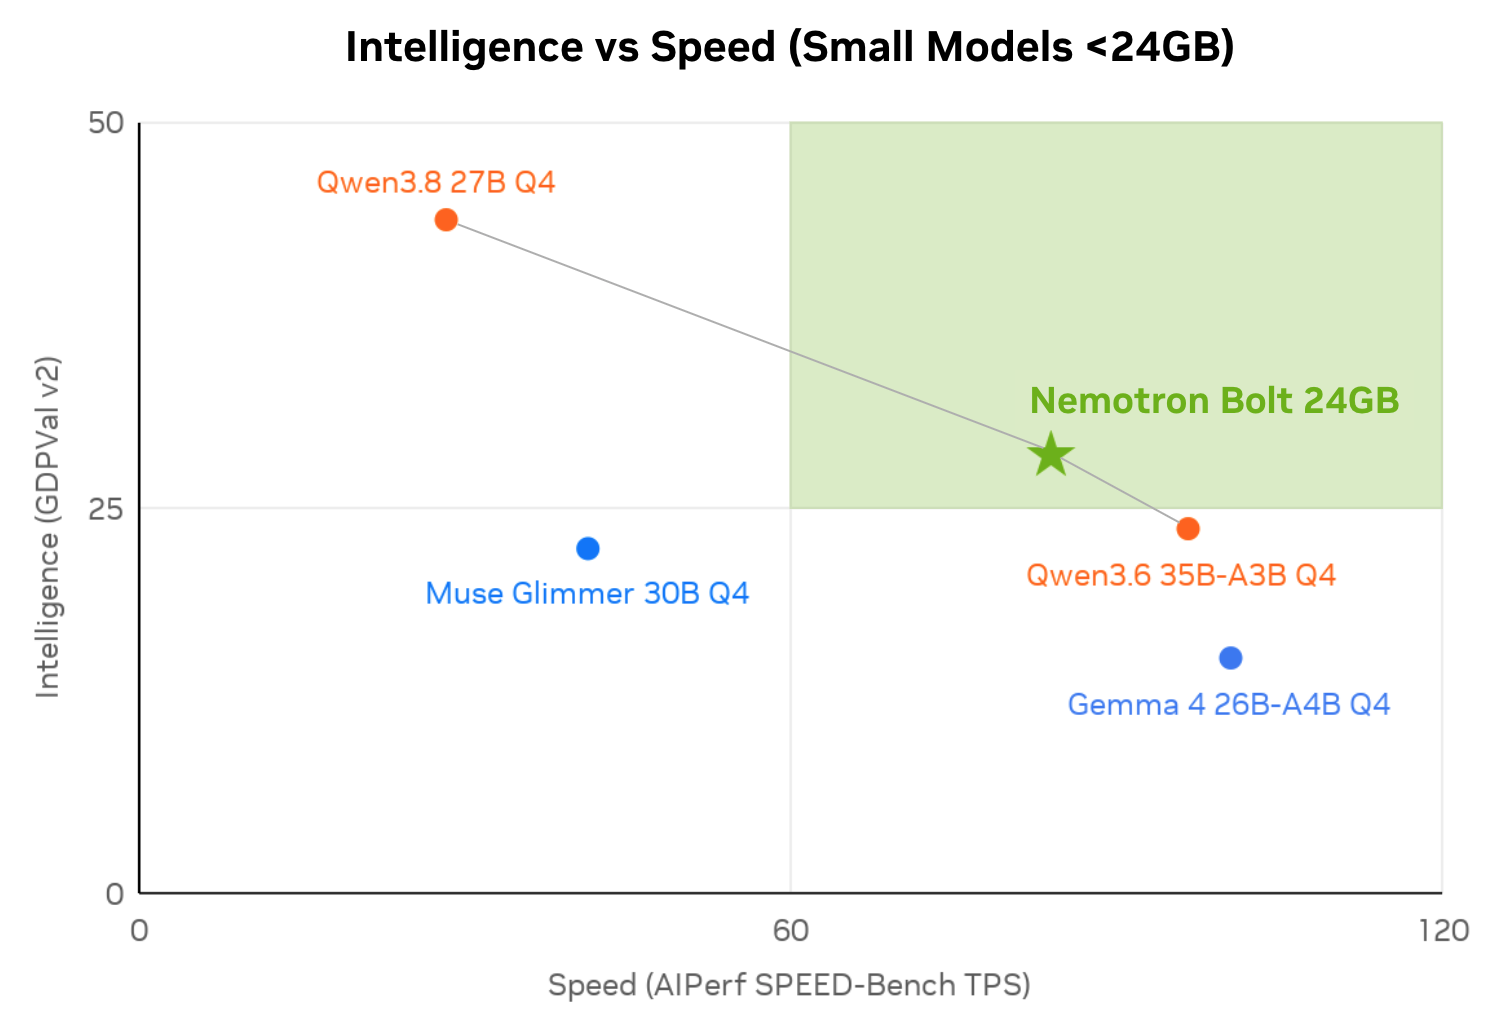
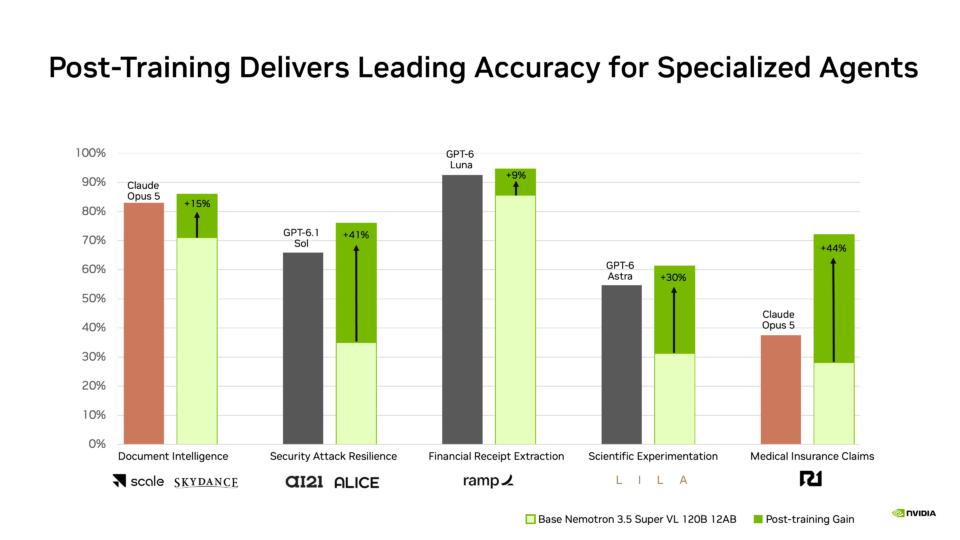
Γράφημα: NVIDIA — Σύγκριση μοντέλων με παρόμοιο αποτύπωμα μνήμης, βάσει συγκεκριμένου benchmark.
Πώς μοιάζει ένας AI agent που λειτουργεί τοπικά;
Για μια πιο πρακτική εικόνα, η NVIDIA έχει δημοσιεύσει οδηγό δημιουργίας ενός always-on βοηθού σε DGX Spark. Το παράδειγμα χρησιμοποιεί το OpenClaw και το NemoClaw, με δυνατότητες πρόσβασης σε εργαλεία και εκτέλεσης εργασιών.
Βίντεο: Πρακτικό tutorial τοπικού AI agent
▶ Δείτε το tutorial της NVIDIA Developer για DGX Spark
Σημαντικό: αυτό το tutorial αφορά την προηγούμενη έκδοση Nemotron 3 Super, όχι το νέο Nemotron 3.5 Bolt. Το συμπεριλαμβάνουμε για να δείξει πώς λειτουργεί στην πράξη ένα τοπικό σύστημα AI agents.
Open weights: Ελευθερία, αλλά όχι χωρίς όρους
Η NVIDIA διαθέτει τα βάρη των μοντέλων και υλικό για την προσαρμογή και ανάπτυξή τους. Ένας οργανισμός μπορεί να εκτελέσει το μοντέλο σε δική του υποδομή και να το εκπαιδεύσει περαιτέρω για τις ανάγκες του.
Αυτό δεν είναι ταυτόσημο με το ότι κάθε στοιχείο του συστήματος προσφέρεται χωρίς περιορισμούς. Πριν από εμπορική χρήση χρειάζεται έλεγχος της άδειας OpenMDW-1.1, των συνοδευτικών εξαρτήσεων και των όρων κάθε υπηρεσίας.
Η τοπική εγκατάσταση μπορεί να προσφέρει μεγαλύτερο έλεγχο των δεδομένων. Δεν διασφαλίζει όμως από μόνη της την ιδιωτικότητα ή την ασφάλεια: ένας agent που χρησιμοποιεί browser, plugins ή άλλες εξωτερικές υπηρεσίες ενδέχεται και πάλι να μεταδίδει πληροφορίες.
Τι αλλάζει για τον προγραμματιστή;
Το ουσιαστικό ερώτημα δεν είναι μόνο πόσες παραμέτρους διαθέτει ένα μοντέλο. Είναι ποιες εργασίες μπορεί να ολοκληρώσει με αξιοπιστία και ποιο είναι το πραγματικό κόστος λειτουργίας του.
Με τις νέες εκδόσεις Nemotron, ένας developer μπορεί να εξετάσει την τοπική αναζήτηση εγγράφων, την ανάλυση logs, την υποβοήθηση ελέγχων κώδικα ή την αυτοματοποίηση εσωτερικών διαδικασιών. Η επιλογή μοντέλου, ωστόσο, πρέπει να γίνει με πραγματικές δοκιμές πάνω στα δικά του δεδομένα και τις εφαρμογές του.
Η κυκλοφορία του Super VL και του Bolt δείχνει μια σαφή τάση: η εξέλιξη του AI δεν αφορά μόνο μεγαλύτερα μοντέλα, αλλά και μοντέλα που αξιοποιούν καλύτερα τη διαθέσιμη μνήμη και υπολογιστική ισχύ.
Το cloud παραμένει σημαντικό, ιδιαίτερα για βαριές εργασίες και μεγάλους αριθμούς χρηστών. Παράλληλα, η δυνατότητα εκτέλεσης πιο ικανών agents σε προσωπικά συστήματα δίνει στους developers περισσότερες επιλογές.
Πηγές και χρήσιμοι σύνδεσμοι
Οπτικό υλικό και διαγράμματα: NVIDIA. Οι μετρήσεις αποδίδονται στις αρχικές τους πηγές και δεν αποτελούν ανεξάρτητο benchmark του CodeCraft.gr.
Φόρτωση σχολίων…