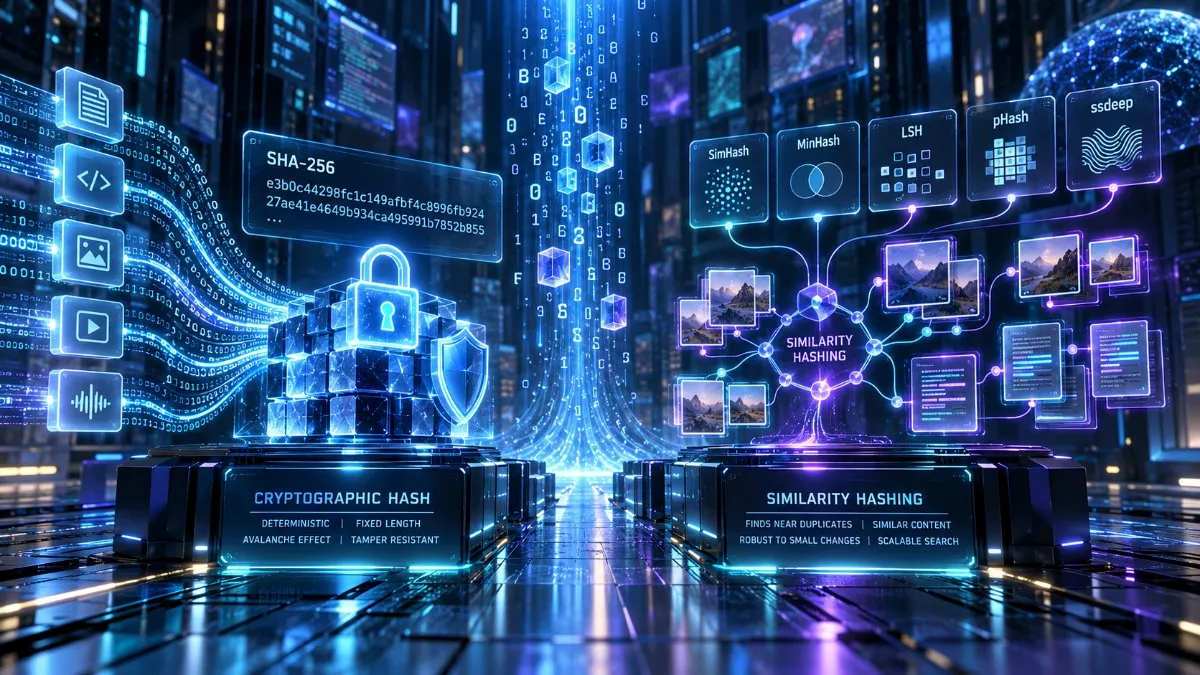
Το Hashing αποτελεί μία από τις σημαντικότερες τεχνικές στην επιστήμη των υπολογιστών. Χρησιμοποιείται στις βάσεις δεδομένων, στην ασφάλεια πληροφοριών, στην αποθήκευση κωδικών πρόσβασης, στην αναζήτηση και στην επεξεργασία μεγάλων όγκων δεδομένων.
Ωστόσο, δεν εξυπηρετούν όλοι οι αλγόριθμοι Hashing τον ίδιο σκοπό.
Για να καταλάβουμε τις διαφορές τους, θα ξεκινήσουμε από τα βασικά.
1. Τι είναι το Hashing;
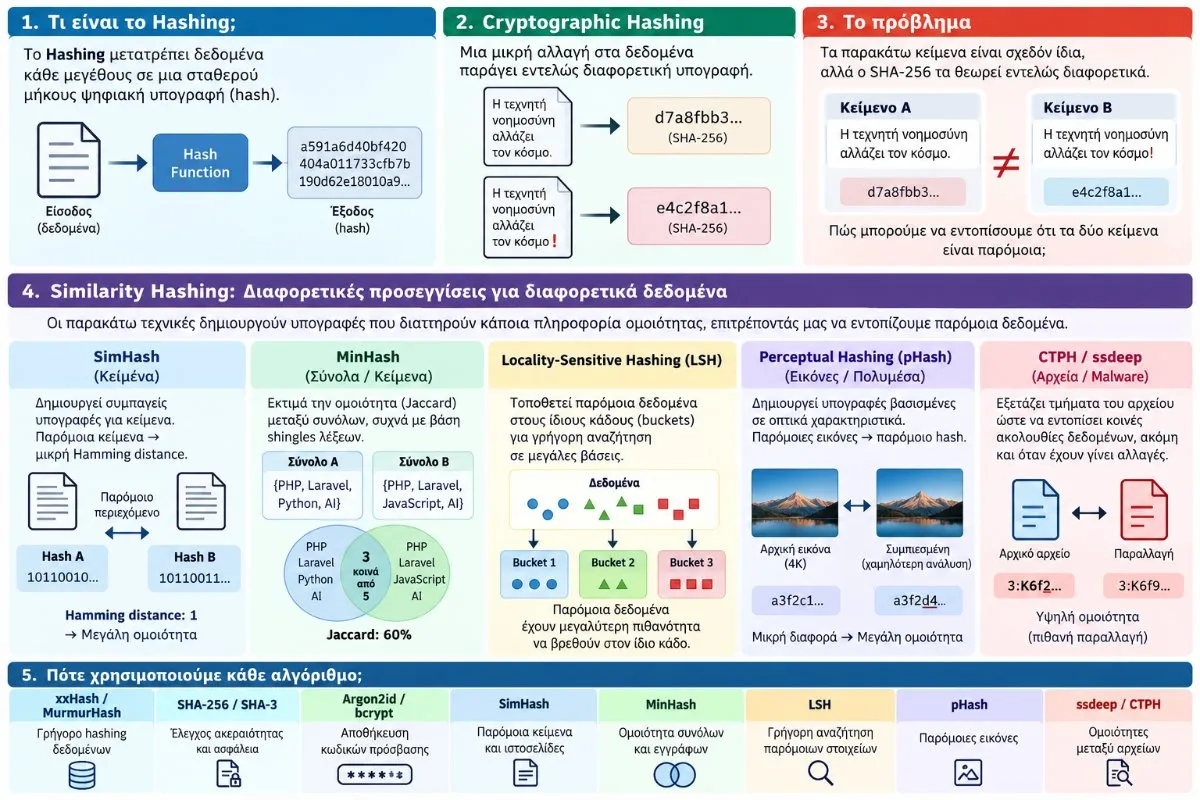
Το Hashing (κατακερματισμός) είναι η διαδικασία κατά την οποία ένας αλγόριθμος δέχεται κάποια δεδομένα ως είσοδο και παράγει μια τιμή που ονομάζεται hash.
Τα δεδομένα μπορεί να είναι μια λέξη, ένας αριθμός, ένα έγγραφο ή ακόμη και ένα αρχείο πολλών gigabytes.
Η συνάρτηση που πραγματοποιεί αυτή τη μετατροπή ονομάζεται Hash Function.
Για παράδειγμα:
Είσοδος:
"Hello World" -> SHA-256 ->Έξοδος (Hash): a591a6d40bf420404a011733cfb7b190
Το σημαντικό είναι ότι η ίδια είσοδος, χρησιμοποιώντας τον ίδιο αλγόριθμο, παράγει πάντοτε την ίδια έξοδο.
Για πολλούς αλγορίθμους Hashing, η έξοδος έχει σταθερό μέγεθος, ανεξάρτητα από το μέγεθος των αρχικών δεδομένων.
Για παράδειγμα, ο SHA-256 παράγει πάντοτε μια υπογραφή 256 bit, δηλαδή 32 bytes.
Έτσι, είτε κατακερματίσουμε μία λέξη είτε ένα ολόκληρο βιβλίο, το τελικό hash έχει το ίδιο μήκος.
Γιατί χρειαζόμαστε το Hashing;
Ας υποθέσουμε ότι έχουμε χιλιάδες αρχεία και θέλουμε να διαπιστώσουμε αν κάποιο υπάρχει ήδη στο σύστημά μας.
Μία λύση είναι να συγκρίνουμε το περιεχόμενό του με κάθε αποθηκευμένο αρχείο.
Μια διαφορετική προσέγγιση είναι να δημιουργήσουμε ένα hash για κάθε αρχείο και να συγκρίνουμε τις υπογραφές τους.
Αν χρησιμοποιούμε έναν κατάλληλο κρυπτογραφικό αλγόριθμο, δύο αρχεία με διαφορετικό hash είναι σίγουρα διαφορετικά.
Αν έχουν ίδιο hash, είναι εξαιρετικά πιθανό να είναι ίδια, αν και μαθηματικά υπάρχει πάντα η πιθανότητα σύγκρουσης (collision).
Το Hashing μάς επιτρέπει επομένως να πραγματοποιούμε γρήγορους ελέγχους χωρίς να επεξεργαζόμαστε επανειλημμένα όλο το αρχικό περιεχόμενο.
Η ίδια γενική ιδέα χρησιμοποιείται στις δομές δεδομένων Hash Tables, όπου ένα κλειδί μετατρέπεται σε μια τιμή που βοηθά να βρούμε γρήγορα τη θέση αποθήκευσης των δεδομένων.
2. Δεν είναι όλοι οι αλγόριθμοι Hashing ίδιοι
Το Hashing δεν είναι ένας μοναδικός αλγόριθμος, αλλά μια ευρύτερη οικογένεια τεχνικών.
Οι κυριότερες κατηγορίες διαφέρουν ανάλογα με το πρόβλημα που προσπαθούν να λύσουν.
Non-Cryptographic Hashing
Οι μη κρυπτογραφικές συναρτήσεις Hashing έχουν σχεδιαστεί κυρίως για ταχύτητα και αποδοτική διαχείριση δεδομένων.
Χρησιμοποιούνται σε Hash Tables, συστήματα προσωρινής αποθήκευσης (caching), βάσεις δεδομένων και άλλες εφαρμογές.
Γνωστοί αλγόριθμοι είναι οι MurmurHash και xxHash.
Δεν έχουν σχεδιαστεί για να αντιστέκονται σε κακόβουλες προσπάθειες δημιουργίας συγκρούσεων ή αλλοίωσης δεδομένων.
Cryptographic Hashing
Οι κρυπτογραφικές συναρτήσεις Hashing προσφέρουν ισχυρότερες εγγυήσεις ασφαλείας.
Γνωστά παραδείγματα είναι οι SHA-256 και SHA-3.
Βασικές ιδιότητές τους είναι:
Deterministic: Η ίδια είσοδος παράγει πάντα την ίδια έξοδο.
Preimage Resistance: Είναι πρακτικά ανέφικτο να ανακτήσουμε την αρχική είσοδο από ένα κατάλληλα επιλεγμένο hash.
Collision Resistance: Είναι εξαιρετικά δύσκολο να δημιουργήσουμε δύο διαφορετικές εισόδους με το ίδιο hash.
Avalanche Effect: Μια πολύ μικρή αλλαγή στην είσοδο προκαλεί μεγάλη και απρόβλεπτη αλλαγή στην έξοδο.
Αυτές οι ιδιότητες είναι ιδιαίτερα χρήσιμες όταν θέλουμε να ελέγξουμε την ακεραιότητα ενός αρχείου.
Για την αποθήκευση κωδικών πρόσβασης, αντίθετα, χρησιμοποιούνται ειδικά σχεδιασμένοι αλγόριθμοι όπως ο Argon2id και ο bcrypt, όχι απλώς ένας γρήγορος SHA-256.
3. Το πρόβλημα: Τι γίνεται όταν δύο αρχεία είναι σχεδόν ίδια;
Ας υποθέσουμε ότι έχουμε δύο κείμενα:
Κείμενο Α:
Η τεχνητή νοημοσύνη αλλάζει τον κόσμο.
Κείμενο Β:
Η τεχνητή νοημοσύνη αλλάζει τον κόσμο!
Η μοναδική διαφορά βρίσκεται στον τελευταίο χαρακτήρα.
Ένας άνθρωπος καταλαβαίνει αμέσως ότι το περιεχόμενο είναι σχεδόν πανομοιότυπο.
Ο SHA-256, όμως, παράγει εντελώς διαφορετικές υπογραφές.
Και αυτό είναι ακριβώς το επιθυμητό αποτέλεσμα για έναν κρυπτογραφικό αλγόριθμο.
Τι γίνεται όμως αν δεν θέλουμε να διαπιστώσουμε αν δύο αρχεία είναι απολύτως ίδια;
Τι γίνεται αν θέλουμε να μάθουμε πόσο μοιάζουν μεταξύ τους;
Για παράδειγμα:
Δύο άρθρα που έχουν σχεδόν το ίδιο περιεχόμενο.
Δύο φωτογραφίες με διαφορετική ανάλυση.
Δύο έγγραφα που διαφέρουν σε λίγες παραγράφους.
Δύο εκδόσεις ενός αρχείου που έχουν κοινά τμήματα.
Εδώ μπαίνουμε στον κόσμο του Similarity Hashing.
4. Fuzzy Hashing: Όταν το Hashing αναζητά ομοιότητες
Το Fuzzy Hashing, γνωστό και ως ασαφής κατακερματισμός, αναφέρεται σε τεχνικές που επιτρέπουν την αναγνώριση παρόμοιων δεδομένων.
Σε αντίθεση με το Cryptographic Hashing, όπου η αλλαγή ενός χαρακτήρα επηρεάζει δραστικά την υπογραφή, αυτές οι τεχνικές προσπαθούν να διατηρήσουν κάποια πληροφορία σχετικά με την ομοιότητα του αρχικού περιεχομένου.
Δεν λειτουργούν, ωστόσο, όλες με τον ίδιο τρόπο.
Ορισμένες δημιουργούν υπογραφές που μπορούμε να συγκρίνουμε μεταξύ τους. Άλλες χρησιμοποιούν στατιστικές προσεγγίσεις ή οργανώνουν τα δεδομένα σε ομάδες για ταχύτερη αναζήτηση.
Πώς μετράμε την ομοιότητα;
Μία μέθοδος είναι η Hamming Distance.
Ας υποθέσουμε ότι έχουμε δύο δυαδικές υπογραφές:
Hash A: 10110100
Hash B: 10110000
Οι υπογραφές διαφέρουν μόνο σε ένα bit.
Επομένως, η Hamming Distance είναι 1.
Σε αλγορίθμους όπως το SimHash, η μικρή απόσταση μεταξύ των υπογραφών μπορεί να αποτελεί ένδειξη μεγάλης ομοιότητας.
Αυτό δεν σημαίνει ότι η απόσταση μετατρέπεται αυτόματα σε κάποιο ακριβές ποσοστό ομοιότητας. Χρειάζεται να γνωρίζουμε τη μέθοδο που δημιούργησε τις υπογραφές.
5. SimHash: Αναγνώριση παρόμοιων κειμένων
Το SimHash αποτελεί μία από τις γνωστότερες τεχνικές για τον εντοπισμό σχεδόν πανομοιότυπων εγγράφων.
Αντί να συγκρίνει κάθε χαρακτήρα δύο κειμένων, εξετάζει χαρακτηριστικά τους, όπως λέξεις ή ομάδες λέξεων, και δημιουργεί συμπαγείς δυαδικές υπογραφές.
Ας υποθέσουμε ότι έχουμε δύο άρθρα με 1.000 λέξεις.
Το δεύτερο άρθρο έχει 950 λέξεις κοινές με το πρώτο και ορισμένες τροποποιήσεις.
Το SimHash μπορεί να δημιουργήσει δύο υπογραφές με μικρή Hamming Distance, επιτρέποντας να εντοπίσουμε τα άρθρα ως πιθανά διπλότυπα.
Η μέθοδος έχει χρησιμοποιηθεί στην αναζήτηση σχεδόν πανομοιότυπων ιστοσελίδων σε μεγάλη κλίμακα, μεταξύ άλλων σε έρευνα της Google.
6. MinHash: Πόσα κοινά στοιχεία έχουν δύο κείμενα;
Το MinHash ακολουθεί διαφορετική λογική.
Χρησιμοποιείται για να εκτιμήσουμε την ομοιότητα δύο συνόλων, συνήθως με βάση τον δείκτη Jaccard.
Για παράδειγμα:
Σύνολο Α:
{PHP, Laravel, Python, AI}

Σύνολο Β:
{PHP, Laravel, JavaScript, AI}
Έχουμε τρία κοινά στοιχεία και πέντε μοναδικά στοιχεία συνολικά.
Η ομοιότητα Jaccard είναι:
3 / 5 = 60%
Το MinHash επιτρέπει να προσεγγίσουμε αυτή την τιμή μέσω μικρών υπογραφών, κάτι ιδιαίτερα χρήσιμο όταν επεξεργαζόμαστε εκατομμύρια έγγραφα.
Στην πραγματική ανάλυση κειμένων, συχνά χρησιμοποιούνται ακολουθίες λέξεων, γνωστές ως shingles, ώστε να αποτυπώνεται καλύτερα η δομή του κειμένου.
7. Locality-Sensitive Hashing: Αναζήτηση σε τεράστιες βάσεις δεδομένων
Ας υποθέσουμε ότι μια μηχανή αναζήτησης διαθέτει 100 εκατομμύρια έγγραφα.
Ακόμη και αν χρησιμοποιεί SimHash ή MinHash, η σύγκριση κάθε νέου εγγράφου με όλα τα υπόλοιπα μπορεί να είναι δαπανηρή.
Το Locality-Sensitive Hashing (LSH) επιχειρεί να μειώσει αυτό το κόστος.
Η βασική ιδέα είναι να τοποθετούμε παρόμοια δεδομένα στους ίδιους κάδους (buckets) με μεγαλύτερη πιθανότητα.
Έτσι, αντί να εξετάζουμε ολόκληρη τη βάση δεδομένων, αναζητούμε πρώτα μέσα σε μικρότερα σύνολα υποψήφιων αποτελεσμάτων.
Το LSH δεν αποτελεί απλώς άλλη ονομασία του Fuzzy Hashing. Είναι μια οικογένεια τεχνικών ευρετηρίασης και προσεγγιστικής αναζήτησης κοντινών γειτόνων που μπορεί να συνδυαστεί με άλλες μεθόδους ομοιότητας.
8. Perceptual Hashing: Πώς αναγνωρίζουμε παρόμοιες εικόνες;
Μέχρι τώρα ασχοληθήκαμε κυρίως με κείμενα και σύνολα δεδομένων.
Τι γίνεται όμως με τις εικόνες;
Ας υποθέσουμε ότι έχουμε μια φωτογραφία σε ανάλυση 4K και δημιουργούμε μια δεύτερη εκδοχή σε χαμηλότερη ανάλυση με συμπίεση JPEG.
Τα δύο αρχεία έχουν διαφορετικά bytes, επομένως διαφορετικό SHA-256.
Οπτικά, όμως, απεικονίζουν το ίδιο πράγμα.
Το Perceptual Hashing (pHash) δημιουργεί μια υπογραφή βασισμένη σε χαρακτηριστικά της εικόνας.
Μπορεί να χρησιμοποιήσει μετασχηματισμούς που αποτυπώνουν τη γενική οπτική δομή, αντί να επεξεργάζεται απλώς τα αρχικά bytes.
Αυτό επιτρέπει την αναγνώριση εικόνων που έχουν υποστεί αλλαγές όπως μικρή τροποποίηση μεγέθους ή συμπίεση.
Δεν λειτουργεί εξίσου καλά σε κάθε είδους αλλαγή, όπως έντονη περικοπή ή μεγάλη περιστροφή.
9. CTPH και ssdeep: Hashing για την κυβερνοασφάλεια
Μια ακόμη προσέγγιση είναι το Context-Triggered Piecewise Hashing (CTPH).
Η συγκεκριμένη τεχνική εξετάζει τμήματα του αρχείου, επιτρέποντας να αναγνωριστούν κοινές ακολουθίες δεδομένων ακόμη και όταν έχουν γίνει ορισμένες αλλαγές.
Ένα γνωστό εργαλείο είναι το ssdeep.
Χρησιμοποιείται στην ψηφιακή εγκληματολογία και στην ανάλυση κακόβουλου λογισμικού.
Για παράδειγμα, ένας αναλυτής μπορεί να εξετάσει αν ένα ύποπτο αρχείο παρουσιάζει σημαντικές ομοιότητες με γνωστά δείγματα malware.
Το αποτέλεσμα δεν αποτελεί από μόνο του απόδειξη ότι το αρχείο είναι επικίνδυνο, αλλά μπορεί να βοηθήσει σημαντικά στη διερεύνηση.
10. Πότε χρησιμοποιούμε κάθε αλγόριθμο;
| Τεχνική | Κύρια χρήση |
|---|---|
| xxHash / MurmurHash | Γρήγορο Hashing δεδομένων |
| SHA-256 / SHA-3 | Έλεγχος ακεραιότητας και ασφάλεια |
| Argon2id | Αποθήκευση κωδικών πρόσβασης |
| SimHash | Παρόμοια κείμενα και ιστοσελίδες |
| MinHash | Ομοιότητα συνόλων και εγγράφων |
| LSH | Γρήγορη αναζήτηση παρόμοιων στοιχείων |
| pHash | Παρόμοιες εικόνες |
| ssdeep / CTPH | Ομοιότητες μεταξύ αρχείων |
11. Hashing και τεχνητή νοημοσύνη: Ποια είναι η διαφορά;
Το Similarity Hashing μπορεί να αναγνωρίσει δεδομένα με κοινά χαρακτηριστικά, αλλά δεν κατανοεί απαραίτητα το νόημά τους.
Για παράδειγμα:
Πρόταση Α: «Το αυτοκίνητο κινείται γρήγορα».
Πρόταση Β: «Το όχημα αναπτύσσει μεγάλη ταχύτητα».
Οι δύο προτάσεις εκφράζουν παρόμοιο νόημα, παρότι χρησιμοποιούν διαφορετικές λέξεις.
Ένας κλασικός αλγόριθμος ομοιότητας κειμένου μπορεί να μην αναγνωρίσει εύκολα αυτή τη σχέση.
Εδώ χρησιμοποιούνται τεχνικές Semantic Similarity, συχνά με μοντέλα τεχνητής νοημοσύνης που παράγουν embeddings.
Τα embeddings μετατρέπουν το περιεχόμενο σε αριθμητικά διανύσματα, επιτρέποντας τη σύγκριση δεδομένων με βάση τη σημασιολογική τους εγγύτητα.
Ένα σύγχρονο σύστημα μπορεί να συνδυάζει Hashing για γρήγορη επεξεργασία, Similarity Hashing για εντοπισμό διπλότυπων και embeddings για σημασιολογική αναζήτηση.
Συμπέρασμα
Το Hashing ξεκίνησε ως μια θεμελιώδης τεχνική για τη γρήγορη οργάνωση, αναζήτηση και αναγνώριση δεδομένων.
Οι κρυπτογραφικοί αλγόριθμοι, όπως ο SHA-256, μας επιτρέπουν να ελέγχουμε με μεγάλη αξιοπιστία αν δύο αρχεία είναι ίδια.
Οι τεχνικές Similarity Hashing προχωρούν ένα βήμα παραπέρα, επιτρέποντάς μας να εξετάζουμε αν δύο αρχεία, εικόνες ή κείμενα παρουσιάζουν σημαντικές ομοιότητες.
Η διαφορά είναι ουσιαστική.
Το Cryptographic Hashing μας βοηθά να αναγνωρίζουμε την ταυτότητα των δεδομένων. Το Similarity Hashing μας βοηθά να ανακαλύπτουμε τις ομοιότητές τους.
Και όταν αυτές οι τεχνικές συνδυάζονται με σύγχρονα συστήματα αναζήτησης και τεχνητής νοημοσύνης, δημιουργούν ισχυρά εργαλεία για τη διαχείριση τεράστιων ποσοτήτων πληροφοριών.
Φόρτωση σχολίων…